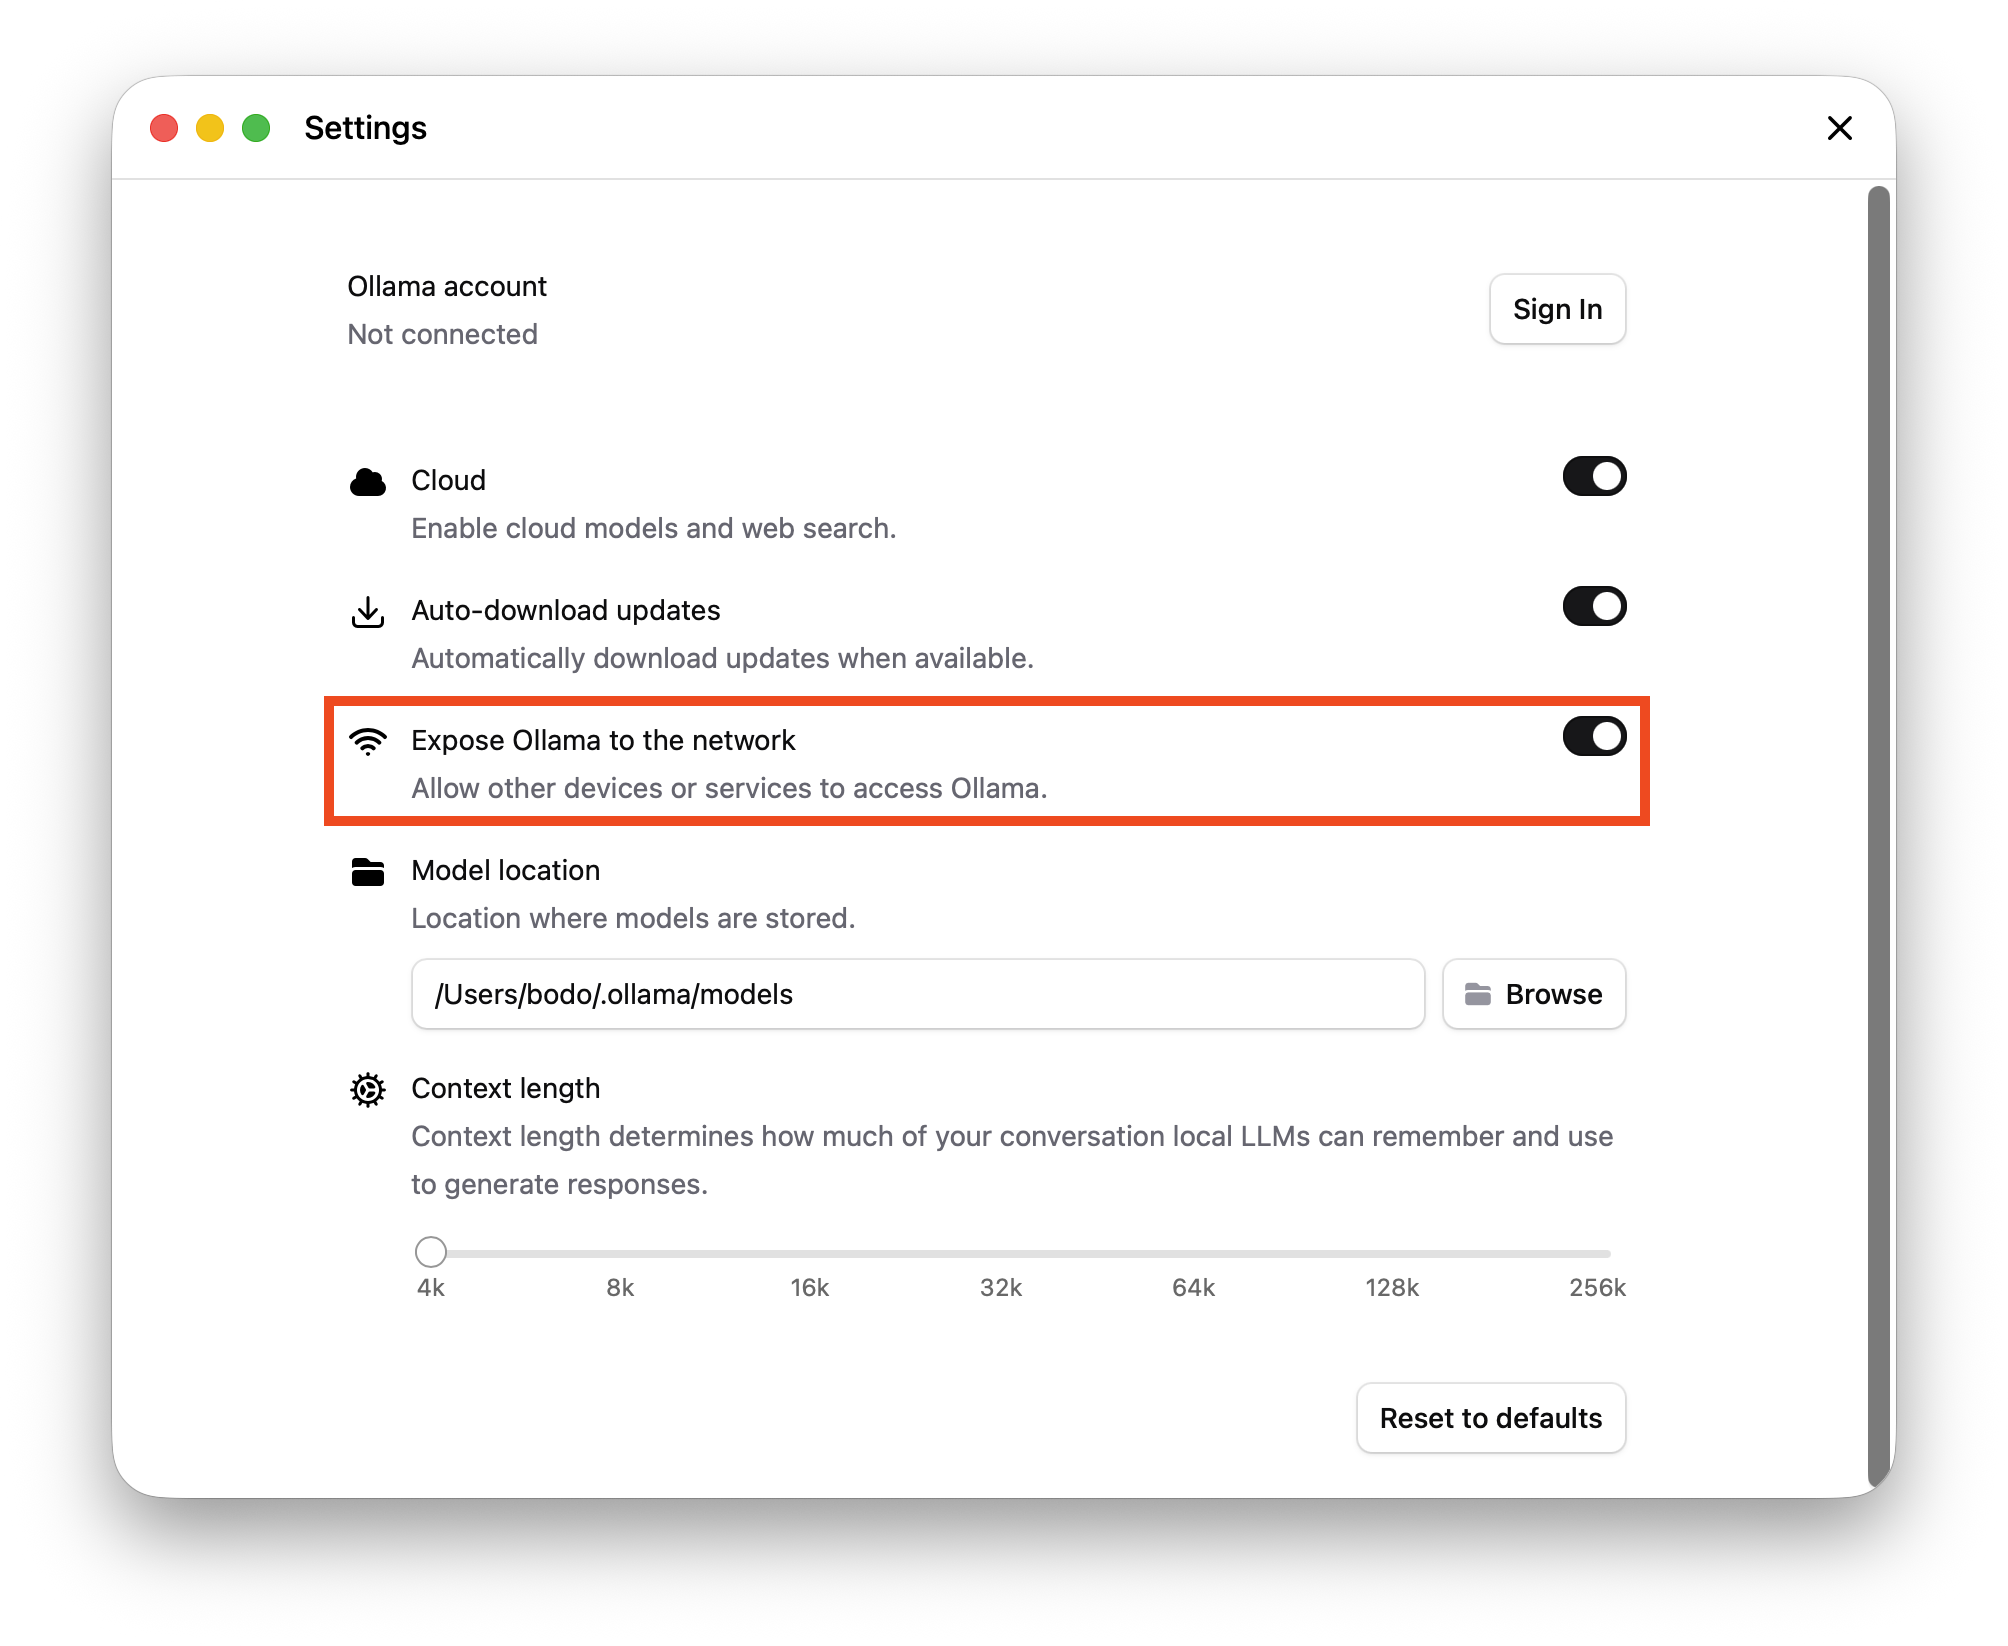
Wie bereits in älteren Blogbeiträgen besprochen, stellt Ollama eine REST-API bereit. Dadurch ist es möglich, von einem anderen Rechner auf die von Ollama verwalteten Sprachmodelle zuzugreifen. In diesem Tutorial wurde erklärt, wie dies im Terminal mit dem Programm curl umgesetzt werden kann. Nun wenden wir uns Python und der requests-Bibliothek zu. Als Sprachmodell verwende ich in diesem Beispiel qwen2.5-coder. Voraussetzung ist, dass auf dem Rechner, auf dem Ollama läuft, in den Ollama-Einstellungen die Option „Expose Ollama to the network“ aktiviert ist.
Das Python-Skript beginnt mit den Import-Anweisungen:
import json
import sys
import requests
from requests.exceptions import RequestException
from pathlib import PathOllama und die Sprachmodelle befinden sich in meinem Netzwerk auf einem Rechner, der die IP-Adresse 192.168.171.31 hat. Dies führt zu folgendem Endpunkt, der der Variable url zugewiesen wird:
url = "http://192.168.171.31:11434/api/generate"Dieses Python-Skript soll die Antwort des Sprachmodells nicht nur im Terminal ausgeben, sondern auch in einer Markdown-Datei (auf dem Schreibtisch) speichern. Für den Pfad wird die pathlib-Bibliothek verwendet, was uns ermöglicht, Pfade unabhängig von der Bezeichnung des Benutzerverzeichnisses zu erstellen. Anstatt also beispielsweise /Users/bodo oder /Users/Julia zu schreiben, lautet der Pfad zum Benutzerverzeichnis stets Path.home().
file = Path.home() / "Desktop" / "generated_output.md"Als nächstes wenden wir uns der Frage zu, die an das Sprachmodell übergeben werden soll. Anzugeben sind das zu verwendende Modell (model), die Frage (prompt), die Optionen (options) und die Angabe, dass der Datenstrom (stream) nicht in mehreren Teilen, sondern nach der fertigen Generierung auf einmal übertragen werden soll.
question = {
    "model": "qwen2.5-coder",
    "prompt": "Erkläre kurz Listen in Python.",
    "options": {"temperature": 0.6, "top_p": 0.9},
    "stream": False,
}Die eigentliche Arbeit übernimmt die Funktion fetch_generated_text(). Mit requests wird die Anfrage an Ollama bzw. das Sprachmodell durchgeführt. Anschließend erfolgt das Parsen der erhaltenen Antwort. Zum Schluß wird noch geprüft, ob ein str vorliegt (und nicht beispielsweise None, dict, list oder int).
In der nachfolgenden Funktion main() wird schließlich die generierte Antwort — sofern kein Fehler aufgetreten ist — im Terminal und als Markdown-Datei ausgegeben.
def fetch_generated_text() -> str:
    """
    Fetch generated text from the Ollama API.
    """

    try:
        # Make a POST request to the Ollama API
        response: requests.Response = requests.post(url, json=question)
        response.raise_for_status()  # Raise an exception for HTTP errors
    except RequestException as e:
        sys.exit(f"No connection to Ollama API or HTTP error.\nDetails: {e}")

    try:
        # Parse the JSON response
        result = response.json()
    except json.JSONDecodeError as e:
        sys.exit(f"Failed to parse JSON response.\nDetails: {e}")

    generated_text = result.get("response")

    # Check if the generated text is a valid string
    if not isinstance(generated_text, str):
        sys.exit("The response does not contain a valid 'response' text.")

    return generated_text

def main() -> None:
    """
    Main function
    """

    answer: str = fetch_generated_text()

    # Print the generated text to the console
    print(answer, end="", flush=True)

    # Save the generated text to a Markdown file
    with open(file, "a", encoding="utf-8") as md_file:
        md_file.write(answer)

if __name__ == "__main__":
main()Damit das Skript funktioniert, solltet ihr sicherstellen, dass Ollama auf dem Zielrechner läuft und ihr das angegebenen Sprachmodell heruntergeladen habt.