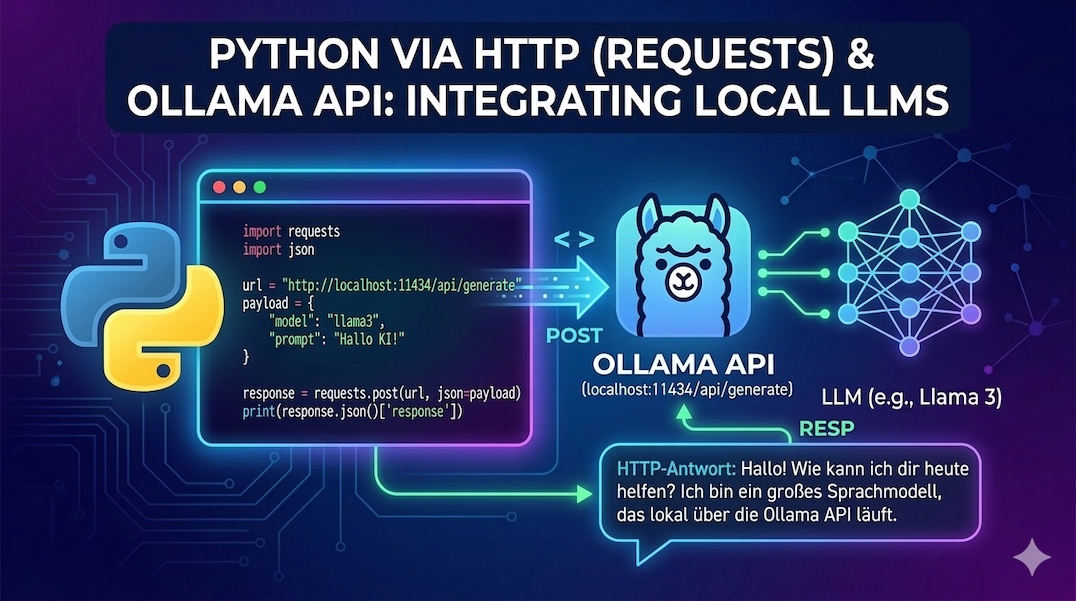
In einem älteren Artikel wurde gezeigt, wie in der Shell mit dem Befehl curl eine Frage an ein vom Ollama verwaltetes Sprachmodell gesendet werden kann. Falls auf dem System als lokale KI das Sprachmodell gemma3 verwendet wird, könnte dies wie folgt aussehen:
curl http://localhost:11434/api/generate -d '{
  "model": "gemma3",
  "prompt": "Who was Ernst Haas?",
  "stream": false
}'In diesem Tutorial wird gezeigt, wie dies mit Python umgesetzt werden kann. Dabei wird ebenfalls auf die Ollama-API zugegriffen, und zwar auf folgenden Endpunkt:
http://localhost:11434/api/generateAls Modell wird verwende ich in diesem Beispiel qwen2.5-coder. Falls ihr ein anderes Sprachmodell nutzt, müßt ihr den Code entsprechend anpassen.
Die Übermittlung der Anfrage an das Sprachmodell erfolgt im JSON-Format. Dementsprechend muss im Python-Skript die Bibliothek json importiert werden. Außerdem benötigen wir requests („HTTP for Humans“), eine Bibliothek, mit der HTTP-Anfragen gesendet werden können. Eine ausführliche Dokumentation findet ihr auf der Internetseite des Requests-Projekts. Da mögliche Verbindungsfehler abgefangen werden sollen, habe ich schließlich noch RequestException hinzugefügt. Die ersten Zeile des Python-Skripts sehen also wie folgt aus:
#!/usr/bin/env python3

import json
import requests
from requests.exceptions import RequestExceptionWie auch schon beim curl-Befehl muss der Endpunkt angegeben werden:
URL = "http://localhost:11434/api/generate"Es handelt sich hierbei um den HTTP-Endpunkt des lokal laufenden Ollama-Dienstes, wobei api/generate die API-Route für die Generierung von Text ist.
Kommen wir als nächstes zu den zu übermittelten Daten (im JSON-Format):
data = {
   "model": "qwen2.5-coder",
   "prompt": "Erstelle in Python eine Liste mit 5 Programmiersprachen und weise sie der Variable `programmiersprachen` zu.",
   "max_tokens": 1000,
   "stream": False,
}Dies ähnelt sehr den Daten, die mit dem Befehl curl übermittelt wurden. In diesem Beispiel ist jedoch noch eine Begrenzung der Token-Anzahl hinzugekommen (max_tokens": 1000).
Die eigentliche Arbeit erledigt nun die Funktion fetch_generated_text():
def fetch_generated_text() -> str:
    """
    Fetch generated text from the Ollama API.
    """

    try:
        # Make a POST request to the Ollama API
        response: requests.Response = requests.post(URL, json=data)  # type: ignore
        response.raise_for_status()  # Raise an exception for HTTP errors
    except RequestException as e:
        sys.exit(f"No connection to Ollama API or HTTP error.\nDetails: {e}")

    try:
        # Parse the JSON response
        result = response.json()
    except json.JSONDecodeError as e:
        sys.exit(f"Failed to parse JSON response.\nDetails: {e}")

    generated_text = result.get("response")

    # Check if the generated text is a valid string
    if not isinstance(generated_text, str):
        sys.exit("The response does not contain a valid 'response' text.")

return generated_textIn diesem Beispiel wird die Anfrage an die Ollama-API in einem try–except-Block verpackt. Diese Ausnahmebehandlung soll sicherstellen, dass das Programm bei einem Verbindungsfehler durch den Aufruf von sys.exit() abbricht. Dies ist zum Beispiel der Fall, wenn Ollama auf dem Rechner nicht im Hintergrund läuft, also nicht gestartet wurde.
Anschließend wird versucht, die empfangenen JSON-Daten zu parsen. Auch hier wird ein try–except-Block verwendet. Schlägt das Parsen fehl, wird sys.exit() aufgerufen und das Skript beendet.
Zum Schluß wird noch geprüft, ob ein valider String zurückgegeben wurde, wobei wieder sys.exit()aufgerufen wurde, falls dies nicht der Fall sein sollte.
In der Funktion main() wird fetch_generated_text() aufgerufen und die Antwort im Terminal ausgegeben:
def main():
    answer: str = fetch_generated_text()

    print(answer, end="", flush=True)

if __name__ == "__main__":
main()Man könnte die Antwort zusätzlich in einem Markdown-Dokument speichern, indem zu main() folgender Code hinzugefügt wird:
with open("generated_output.md", "a", encoding="utf-8") as md_file:
md_file.write(answer)Die Funktion fetch_generated_text() könnte auch anders aussehen. Wenn Ihr euch im Internet nach Beispielen zur Verwendung von requests umseht, werdet Ihr andere Implementierungen finden. Versteht die hier gewählte Variante nur also als Vorschlag für euer eigenes Skript.
Weitere Artikel zu diesem Thema
- Die Ollama-Bibliothek für Python
- Zugriff auf Ollama über das Netzwerk (mit curl)
- Zugriff auf Ollama über das Netzwerk (mit requests)
- Zugriff auf ein lokales Modell per Shell-Skript
Zuletzt aktualisiert am 22. September 2026